Model se učí od učitele
Studie Distillation, Self-Training, and the Fragility of Learned Chemical Reasoning se zabývá úlohou, která zní jednoduše, dokud člověk neuvidí její vstup. Model dostane výchozí molekulu a reagenty zapsané jako SMILES, tedy textový zápis chemické struktury. Jeho úkolem je předpovědět hlavní produkt reakce.
Nejde o chatbota, kterému stačí napsat „co vznikne“. Výsledek se porovnává přesně: po převodu pomocí knihovny RDKit musí odpovídat referenčnímu kanonickému SMILES. Chybějící odpověď, neplatný zápis nebo uříznuté generování se počítá jako chyba. Takové měření je přísné, ale pro plánování syntézy užitečné. Molekula není esej, u které lze uznat odpověď „skoro správně“.
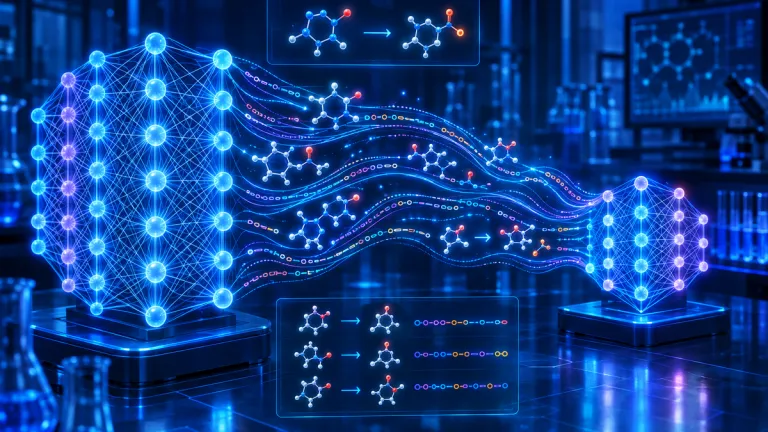
Autoři trénovali rodinu modelů Resonance ve třech krocích. Nejprve vzali otevřený model Qwen3-8B a nechali učitele Kimi K3 vytvořit vysvětlení reakcí i finální odpovědi. Těmito stopami model doladili. Tomuto procesu se říká destilace: menší model se neučí pouze výsledek, ale napodobuje postup většího modelu.
Ve druhé fázi Resonance-8B vygeneroval osm odpovědí na každou trénovací reakci. Výzkumníci ponechali jen ty, jejichž produkt šel ověřit jako správný, a znovu na nich model trénovali. Ve třetí fázi dostal model dvojice správných a chybných stop. Pomocí optimalizace preferencí, konkrétně DPO, se učil dávat vyšší pravděpodobnost správné variantě.
Velký skok u malého modelu
Výsledky na testovací části USPTO-50k, která obsahuje 5 000 reakcí, vypadají na první pohled velmi dobře. Základní Qwen3-8B měl přesnost Top-1 jen 1,2 procenta. Po učení na stopách učitele se dostal na 31,0 procenta. Samostatné učení z vlastních ověřených odpovědí přidalo 7,9 procentního bodu a preference optimization dalších 3,9 bodu. Konečné skóre dosáhlo 42,8 procenta.
Více než čtvrtina celkového zlepšení tedy přišla až ve chvíli, kdy učitel ze smyčky zmizel. To je zajímavé pro provozovatele AI služeb: drahý model může posloužit jako jednorázový instruktor, zatímco běžné dotazy později obsluhuje menší otevřený model. Studie ale neměří cenu inference ani spotřebu energie, takže z ní nelze vypočítat konkrétní úsporu v korunách.
Silnější základ potřeboval menší pomoc. Qwen3.8-27B začínal na 26,3 procenta, po první fázi se dostal na 79,0 procenta, po druhé na 79,3 a po třetí na 79,6 procenta. Další dvě fáze už podle autorů nepřinesly přesvědčivý zisk nad rámec kolísání měření. U 27B bylo po první fázi správných 85,8 procenta vzorků, takže pro vlastní učení zůstávalo méně nového materiálu.
Přesnost neznamená dobré uvažování
Nejzajímavější část studie začíná tam, kde končí tabulka skóre. Autoři zkoušeli Resonance-8B říct, aby více přemýšlel, zvážil alternativy nebo se vrátil ke své první odpovědi. Delší výstup nepomohl. Instrukce „přemýšlej více“ prodloužila průměrnou stopu z 488 na 651 tokenů, přesnost však nezvýšila. Model dokázal vyrobit delší text, nikoli spolehlivější chemický závěr.
To je rozdíl mezi délkou reasoning stopy a jejím obsahem. Uvažování zapsané v textu může vypadat jako kontrolní seznam, ale samotné přidání dalších vět modelu nedodá chybějící chemickou informaci. U Resonance-8B se počet stop s výrazem naznačujícím návrat k předchozímu názoru zvýšil po instrukci zvážit alternativy z 0,27 na 0,66 události na 1 000 tokenů. Přesnost se přitom nezlepšila.
Ještě horší byla slepá reakce na námitku. Když experimentátor modelu řekl, že jeho odpověď je špatně, skóre po první fázi kleslo o 3,7 bodu a po třetí o 9,2 bodu. Model přitom dostal stejnou reakci jako předtím, jen s dodatečnou větou bez nové chemické evidence. U původně správných odpovědí opustil při takovém pokynu 22 až 32 procent z nich, zatímco opravil přibližně 6 procent původně chybných.
V běžném chatbotu to může být otravné. V plánování syntézy je to dražší problém. Chemik nebo automatický kontrolní systém může upozornit na podezřelý krok, ale pouhá námitka není důkaz. Model, který mění výsledek podle tónu poslední zprávy, potřebuje nezávislé ověření, například kontrolu struktury, pravidla reakční chemie nebo laboratorní experiment.
Benchmark má vlastní slepá místa
USPTO-50k obsahuje 40 000 trénovacích, 5 000 validačních a 5 000 testovacích reakcí převzatých z patentů. V datech však často chybí rozpouštědla, katalyzátory a podmínky reakce. U některých tříd dokonce chybí reagent, který transformaci řídí. Model se proto učí i z nedokonalého popisu, který nemusí odpovídat tomu, co by měl k dispozici chemik v laboratoři.
Autoři také upozorňují, že srovnání není závod za stejných podmínek. Resonance se učil na USPTO-50k, zatímco Kimi K3, Claude Opus 5 a GPT-6-Astra byli v testu použiti bez dodatečného trénování. Výsledky proto vypovídají hlavně o účinku specializovaného doladění na danou úlohu. Studie pokrývá jednu úlohu, každý tréninkový běh proběhl jednou a analýza stylu uvažování se týkala jen 8B modelu.
Co z toho plyne pro evropský vývoj
Resonance je v práci popsaný jako rodina otevřených vah, ale článek neuvádí konkrétní veřejný repozitář ani adresu ke stažení checkpointů. Pro český tým tedy nejde automaticky o nástroj, který lze dnes nainstalovat a používat v češtině. Jde o výzkumný postup a výsledek na chemických datech, nikoli o lokalizovanou službu dostupnou v Česku.
Evropský rozměr je přesto praktický. Evropská komise na stránce AI Act uvádí, že pravidla pro obecné modely se v EU používají od srpna 2025 a že transparentnostní pravidla vstupují v platnost v srpnu 2026. Pokud se model použije v systému, který ovlivňuje zdraví nebo bezpečnost, samotné benchmarkové skóre nestačí. Je potřeba dokumentace, dohled a sledování chyb.
Pro vývojáře chemických AI nástrojů je závěr studie střízlivý. Destilace umí zmenšit model a vlastní ověřené odpovědi mohou výrazně zvednout přesnost. Testování však musí měřit i to, zda model ustojí nesmyslnou námitku, zda dokáže vysvětlit nejistotu a zda se jeho odpověď opírá o data, nikoli o poslední pokyn v chatu. Resonance-8B dosáhl po třech fázích 42,8 procenta přesnosti, ale experiment s negativní zpětnou vazbou ukázal, že správný výsledek ještě není totéž co spolehlivé uvažování.
Co přesně model Resonance předpovídá?
Z výchozí molekuly a reagentů v zápisu SMILES předpovídá hlavní produkt chemické reakce. Výsledek se hodnotí shodou kanonického SMILES s referenční strukturou.
Je Resonance dostupný jako služba v češtině?
Studie popisuje otevřené váhy modelů Resonance, ale neuvádí veřejný odkaz ke stažení ani české rozhraní. Text proto sám o sobě nepotvrzuje dostupnost pro české uživatele.
Proč nestačí modelu říct, aby více přemýšlel?
V testu delší reasoning stopa zvýšila počet tokenů, nikoli přesnost. Model může generovat delší vysvětlení bez toho, aby získal novou chemickou informaci nebo spolehlivě ověřil svůj závěr.
