AI správně poskládá protein, ale může uvnitř porušit fyziku
Studie v PNAS ukazuje, že AI modely pro predikci proteinů mohou u zmutovaných sekvencí ukrýt nabité aminokyseliny do hydrofobního jádra. Krátká molekulární simulace chybu odhalí.
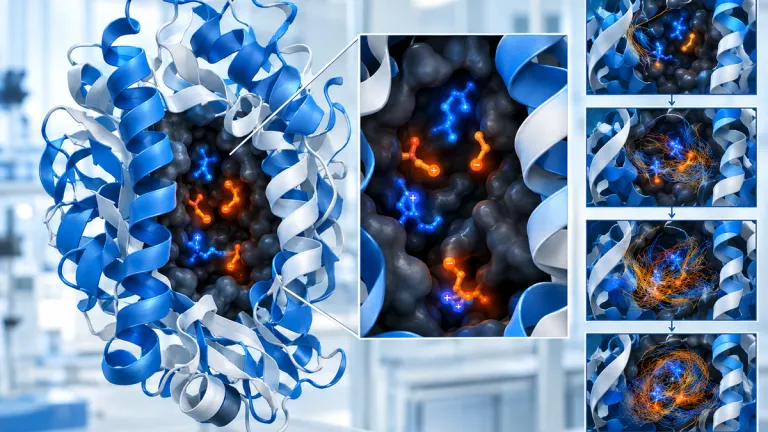
AI zachovala původní tvar, skutečný protein se změnil
Výzkum George I. Makhatadzeho z Rensselaer Polytechnic Institute se zaměřil na protein U1A. Vědci zkoumali variantu, která obsahovala čtyři záměny za ionizovatelné aminokyseliny. Tyto aminokyseliny mohou podle svého okolí získat nebo ztratit proton, a tím změnit elektrický náboj.
Laboratorní měření ukázala, že upravená varianta se nechová jako původní U1A. Vytvořila trimer, tedy komplex složený ze tří proteinových jednotek, zatímco přirozená varianta je monomer. Zároveň měla dvojnásobný podíl helikální struktury.
Modely umělé inteligence ovšem dospěly k jinému výsledku. AlphaFold2, RoseTTAFold2, OmegaFold a ESMFold předpověděly struktury téměř shodné s původním proteinem. Odchylka páteře proteinu byla menší než 1 angström, tedy méně než desetimiliontina milimetru.
Číslo samo o sobě vypadá jako velmi dobrý výsledek. Jenže zde popisovalo podobnost s nesprávným vzorem. Modely trefily geometrické uspořádání podobné původnímu U1A, ale přehlédly, že změny v sekvenci mohou změnit celkové chování proteinu.
Problém ukrytý uvnitř hydrofobního jádra
Proteiny nejsou jen řetězce aminokyselin složené do libovolného trojrozměrného tvaru. Jejich části spolu reagují podle fyzikálních pravidel. Nepolární neboli hydrofobní aminokyseliny mají tendenci ukrývat se uvnitř struktury, kde nejsou v kontaktu s vodou. Nabité a silně polární skupiny se obvykle nacházejí na povrchu, případně jsou uvnitř stabilizovány vhodnými vazbami.
Testované AI modely u některých sekvencí předpověděly ionizovatelné zbytky pohřbené v nepolárním jádru. Taková struktura může vypadat stabilně v grafickém výstupu modelu, ale fyzikálně je podezřelá. Model totiž nepočítá každý detail podobně jako klasická simulace molekul. Učí se statistické vzorce z velkého množství známých proteinů.
To funguje velmi dobře u přirozených sekvencí, které se podobají tréninkovým příkladům. U uměle změněných nebo zcela nových sekvencí však může model zachovat celkový tvar známého proteinu, i když nové chemické vlastnosti takové uspořádání destabilizují.
Test s tisíci sekvencí
Autoři studie problém neověřili pouze na jedné mutaci. Vytvořili také tisíce sekvencí U1A, v nichž se do nepolárního jádra postupně dostávaly ionizovatelné aminokyseliny. V některých případech jich bylo až 12.
Modely často dál zachovávaly původní skládání U1A. Výsledkem byla struktura, která vypadala jako běžný protein, přestože obsahovala nabité zbytky uvnitř prostředí, kde by se podle fyzikálně-chemických pravidel měly chovat jinak.
Stejný jev vědci sledovali také u acylfosfatázy a de novo navrženého proteinu TOP7. Nešlo tedy pouze o jednu konkrétní chybu v jediném modelu nebo jediné sekvenci. Studie však zároveň neříká, že AI predikce proteinů jsou obecně nepoužitelné. Testovaný problém byl úzce zaměřený na elektrostatiku a uměle změněné sekvence.
Krátká simulace chybu odhalila
Další část experimentu využila molekulární dynamiku. Jde o výpočetní metodu, která sleduje pohyb atomů v čase podle fyzikálních sil. Místo statického obrázku tak vědci sledují, zda se navržená struktura během simulace drží pohromadě.
U chybných struktur stačila simulace dlouhá 50 nanosekund. Použita byla silová pole CHARMM a AMBER. Nabité aminokyseliny se během výpočtu začaly přesouvat směrem k rozpouštědlu a struktura se odchylovala od původního AI návrhu.
V dodaných výsledcích se jako praktické vodítko uvádí drift RMSD nad 2,5 angströmu u chybných struktur. RMSD měří, jak moc se struktura změnila proti výchozímu stavu. Vyšší hodnota sama o sobě neznamená, že je protein automaticky špatně, v tomto experimentu však pomohla odhalit porušení elektrostatických principů.
Výpočet trvající desítky nanosekund proto může fungovat jako kontrolní filtr. Neprokazuje, že výsledný protein bude v laboratoři fungovat, ale může upozornit na návrh, který se začne rozpadat nebo měnit dříve, než se dostane k experimentálnímu ověření.
Co studie mění v práci s proteinovou AI
Predikce struktury a fyzikální validace řeší dvě odlišné otázky. První se ptá, jak může protein vypadat. Druhá zkoumá, zda takové uspořádání odpovídá chemickému prostředí, ve kterém se má nacházet.
Současné modely dokážou u přirozených proteinů poskytovat velmi přesné geometrické predikce. Tato studie ale ukazuje, že dobrá geometrická shoda nemusí stačit při návrhu mutací nebo zcela nových sekvencí. Model může vytvořit strukturu, která připomíná známý protein, aniž by správně popsal změny náboje, protonace nebo stability.
V praxi to znamená, že AI výstup by u rizikových sekvencí neměl být posledním krokem. Kromě krátké molekulární dynamiky mohou vědci využít také experimentální měření, výpočty pKa, energetické analýzy nebo další fyzikálně založené metody. Žádná z nich sama o sobě nenahradí laboratorní ověření.
Pro české výzkumné týmy nejde o nový spotřebitelský nástroj s českým rozhraním nebo samostatným tarifem. Výsledky se týkají vědeckých workflow a softwaru pro strukturální biologii. Jednotlivé modely a simulační balíky mohou být dostupné podle licence a výpočetní infrastruktury dané laboratoře. Cena konkrétního výpočtu proto není v této studii uvedena jako jednotný údaj.
Benchmark zde nestačí
Studie také dobře ukazuje, proč nelze kvalitu proteinového modelu shrnout jediným skóre. Běžné testy mohou měřit podobnost predikované struktury s experimentálně známým vzorem. V tomto případě však modely dosáhly velmi malé geometrické odchylky, a přesto poskytly nesprávný biologický popis varianty.
Nejde tedy o srovnání typu „jeden model je lepší než druhý“ podle jediného žebříčku. Autoři testovali AlphaFold2, RoseTTAFold2, OmegaFold a ESMFold na konkrétním problému. Výsledky ukazují společné omezení několika přístupů při práci s ionizovatelnými zbytky, nikoli univerzální pořadí všech nástrojů pro predikci proteinů.
Pro návrh nových proteinů je proto důležitější celý postup než samotný název modelu. AI může rychle vytvořit kandidátní strukturu. Fyzikální výpočet pak prověří, zda se v ní neukrývá problém, který obrázek ani běžné skóre neukážou.
FAQ
Co je ionizovatelná aminokyselina?
Je to aminokyselina, jejíž elektrický náboj se může měnit podle okolního prostředí, například podle pH. Tato změna ovlivňuje stabilitu a chování proteinu.
Znamená studie, že AI neumí predikovat struktury proteinů?
Ne. Studie se zaměřila na konkrétní problém s elektrostatikou u zmutovaných a uměle vytvořených sekvencí. U přirozených proteinů mohou AI modely poskytovat velmi přesné predikce, jejich výstup však nemusí být bez další kontroly vhodný pro každý nový návrh.
Proč se používá molekulární dynamika?
Molekulární dynamika sleduje pohyb atomů podle fyzikálních sil. Umožní proto zjistit, zda se statická AI struktura během krátkého výpočtu udrží, nebo se některé její části začnou přesouvat do chemicky vhodnější polohy.