Shrnutí v bodech
- Inženýři Huawei pracují přímo v kancelářích DeepSeeku a podle potřeb jeho modelů upravují výpočetní jednotky i přenosy dat u čipů chystaných na rok 2027 a další léta.
- DeepSeek chce koncem roku 2026 nasadit na trénink čipy Ascend 950DT a v prvním čtvrtletí 2027 má od Huawei přednostně získat většinu nové generace Ascend 960DT.
- Open-source jazyk TileLang a knihovny DeepGEMM-Ascend, DeepEP-Ascend a FlashMLA umožňují spouštět stejný výpočetní kód na kartách Nvidia i na čipech Huawei Ascend 950 až na 95 % teoretického stropu čipu.
- Podle výzkumného institutu Epoch AI má čip Nvidia B300 v přesnosti FP4 výkon 13,5 PFLOPS oproti 2 PFLOPS u Ascend 950 (6,75násobný rozdíl) a Huawei letos vyrobí méně než 4 % celkového výpočetního výkonu Nvidie.
Inženýři Huawei přímo v kancelářích DeepSeeku
Běžný vztah mezi výrobcem čipů a vývojářem umělé inteligence vypadá jednoduše: čipová firma navrhne procesor, vydá k němu vývojářské nástroje a softwarové laboratoře se mu přizpůsobí. Mezi čínským telekomunikačním gigantem Huawei Technologies a startupem DeepSeek teď ale probíhá mnohem těsnější spolupráce. Podle pondělní zprávy serveru The Information, která se odvolává na dva lidi obeznámené s projektem a jejíž závěry shrnuly servery Yahoo Finance a Finimize, vyslal Huawei své hardwarové inženýry na dlouhodobou stáž přímo do sídla DeepSeeku.
Na místě neřeší jen ladění hotového softwaru. Požadavky tvůrců modelů promítají přímo do návrhu budoucích čipů řady Ascend, které mají přijít na trh v roce 2027 a v následujících letech. Úpravy se týkají dvou míst, na nichž se u dnešních velkých jazykových modelů láme výkon: jak přesně čip provádí maticové výpočty a jak rychle si jednotlivé procesory předávají data mezi sebou.
Podle zjištění The Information plánuje DeepSeek začít využívat čipy Huawei Ascend 950DT pro trénink modelů už koncem roku 2026. U navazující generace Ascend 960DT, jejíž uvedení Huawei nedávno urychlil o tři čtvrtletí na první kvartál roku 2027, pak výrobce počítá s tím, že většinu dodávek vyhradí přednostně právě pro DeepSeek.
Proč nestačí jen křemík: TileLang jako most přes příkop Nvidie
Aby bylo srozumitelné, o co se obě čínské firmy snaží, je potřeba podívat se na to, proč má americká Nvidia na trhu s AI tak silnou pozici. Její náskok nestojí jen na rychlých čipech. Stejně důležitou roli hraje softwarová platforma CUDA, kterou Nvidia buduje téměř dvě desetiletí a ve které dnes po celém světě programují zhruba čtyři miliony vývojářů. Kdo chtěl přenést trénink velkého modelu z Nvidie na čínské čipy Huawei Ascend, narazil na jejich vlastní rozhraní CANN. Přepsat a odladit nízkoúrovňový kód pro jinou architekturu znamenalo měsíce práce a často i propad reálného výkonu.
Právě tuto bariéru má obejít otevřený programovací jazyk TileLang. Původně jej vyvinuli výzkumníci z Pekingské univerzity nad kompilátorem TVM a DeepSeek ho už zhruba rok používá jako svůj hlavní nástroj pro psaní výpočetních jader. Zjednodušeně řečeno funguje TileLang jako univerzální překladač mezi AI modelem a křemíkem. Vývojář v něm napíše výpočetní operaci přehledným zápisem blízkým Pythonu a kompilátor ji na pozadí přeloží do nízkoúrovňových instrukcí konkrétního čipu, ať už jde o grafickou kartu Nvidia, nebo o akcelerátor Huawei Ascend.
Koncem září 2026 udělal DeepSeek krok, kterým tuto vrstvu zpřístupnil celému trhu. Podle serveru Tom's Hardware a dokumentace na GitHubu uvolnil s plnou podporou inženýrů Huawei kompletní sadu otevřených nástrojů pro čipy Ascend 950. Většina operátorů, které DeepSeek používá při tréninku své současné rodiny modelů V4 (včetně DeepSeek-V4 Pro a DeepSeek-V4.1 Flash), je už napsaná v jazyce TileLang a každý z nich má nově přímý protějšek optimalizovaný pro čipy Ascend.
Spolu s kompilátorem otevřel DeepSeek také specializované knihovny se stejným programovým rozhraním, jaké vývojáři znají z Nvidie. Knihovna DeepGEMM-Ascend se stará o maticové násobení v přesnostech BF16, FP8 a FP4. Komunikační vrstva DeepEP-Ascend řídí rychlou výměnu dat mezi čipy u modelů se smíšenými experty (MoE), přičemž na testovacím supernodu se 128 čipy Ascend 950DT dosahuje při rozesílání dat propustnosti 313 až 375 GB/s, tedy 90 až 95 procent fyzického limitu sítě do 32 uzlů. Třetí pilíř, knihovna FlashMLA pro řídkou pozornost, pak na čipu Ascend 950 vytěží při zpracování vstupního kontextu 410 TFLOPS (95 % teoretického maxima čipu) a při generování odpovědi 360 TFLOPS (83 % maxima).
Rozdíl mezi provozem a tréninkem od nuly
Pro laika může znít zvláštně, proč je trénink nového modelu na čínských čipech tak velkým tématem, když už na nich čínské firmy umělou inteligenci běžně provozují. V praxi jde ale o dvě zcela odlišné disciplíny.
Když už je model natrénovaný a odpovídá uživatelům v chatu nebo přes API (takzvaná inference), lze zátěž snadno rozdělit mezi menší skupinky čipů nezávisle na sobě. Právě na tuto práci si DeepSeek podle zářijové zprávy agentury Bloomberg objednal nejméně 160 000 čipů Huawei Ascend 950DT pro obří gigawattové datacentrum ve městě Ulanqab ve Vnitřním Mongolsku. Podobně v červnu 2026 akademický tým v Šen-čenu úspěšně dokončil dodatečné doladění (post-training) 1,6bilionového modelu V4-Pro na clusteru tisíce starších karet Ascend 910C.
Trénink zcela nového špičkového modelu od nuly (pre-training) je však nesrovnatelně tvrdší oříšek. Desetitisíce čipů při něm musí pracovat jako jeden obří mozek, po každém výpočetním kroku si vyměnit biliony parametrů a čekat na nejpomalejší článek řetězce. Když DeepSeek v srpnu 2025 pod tlakem čínských úřadů zkoušel trénovat svůj tehdejší model R2 na čipech Huawei, narazil na přehřívání a výpadky čipů, pomalé propojení mezi servery a nedozrálý software. Nakonec se musel pro samotný trénink vrátit k čipům Nvidie a hardware od Huawei ponechat jen na provoz hotového modelu.
Tři překážky: sedmkrát nižší výkon, paměti HBM a poruchovost
Ani se společným návrhem čipů a jazykem TileLang proto Čína nevyřeší odříznutí od západních technologií přes noc. Samotný DeepSeek podle The Information čipy Nvidie neopouští a dál hledá cesty, jak se k jejím nejvýkonnějším akcelerátorům dostat. Detailní srovnání výzkumného institutu Epoch AI ze září 2026 ukazuje tři technické bariéry, které čínský hardwarový ekosystém stále brzdí:
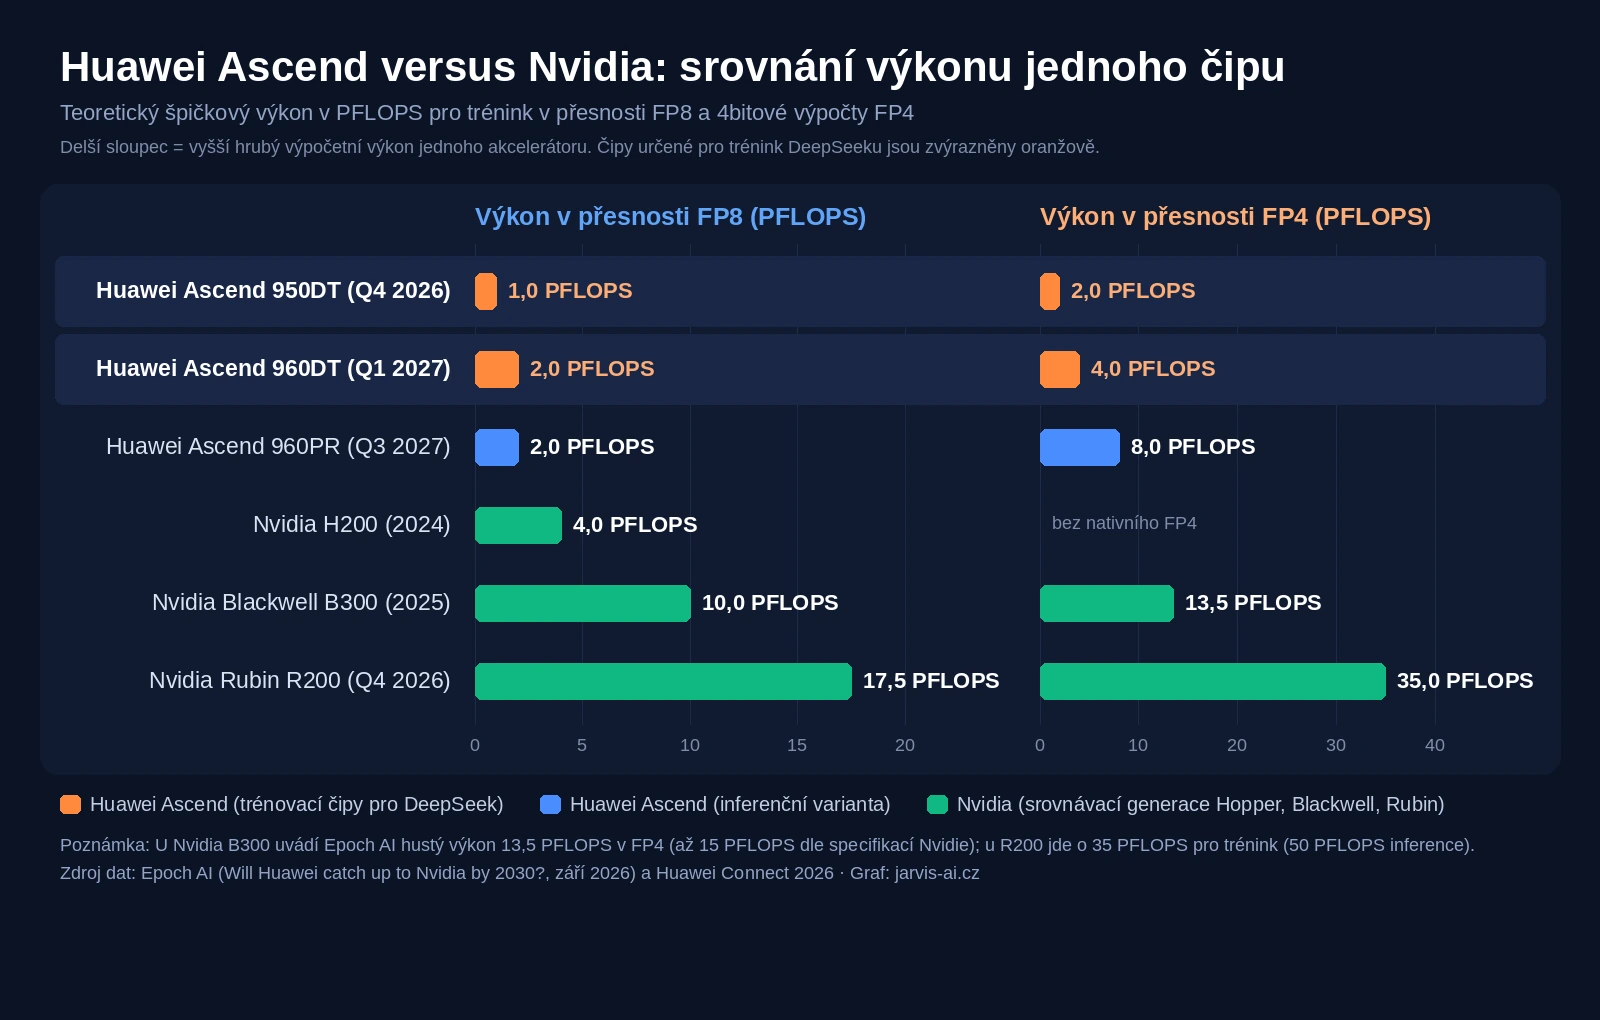
1. Hrubý výkon jednotlivého čipu. Současný vrcholný čip Huawei Ascend 950 dosahuje ve 4bitových výpočtech (FP4) teoretického maxima 2 PFLOPS, zatímco Nvidia B300 nabízí 13,5 PFLOPS (v novějších konfiguracích až 15 PFLOPS). Americký čip má tak v hrubé aritmetice 6,75násobný náskok, který média zjednodušeně označují za sedminásobný. Ještě výraznější je rozdíl u přesnosti FP8 používané při tréninku: Ascend 950DT nabízí 1 PFLOPS, což odpovídá zhruba polovině výkonu čtyři roky starého čipu Nvidia H100 z roku 2022 a desetině výkonu B300 (10 PFLOPS). Chystaný Ascend 960DT pro začátek roku 2027 sice zdvojnásobí trénovací výkon na 2 PFLOPS v FP8 (a 4 PFLOPS v FP4 s 288 GB paměti), jenže Nvidia už na konec roku 2026 chystá generaci Rubin R200 se 17,5 PFLOPS v FP8 a až 50 PFLOPS v FP4. Zaostávání čipů Huawei o tři až čtyři roky tak podle Epoch AI potrvá nejméně do roku 2030.
2. Spolehlivost obřích trénovacích clusterů. Protože má jeden čip Huawei zlomkový výkon, musí čínské laboratoře dohánět manko hrubou silou a spojovat do jednoho celku mnohem více procesorů. Podle The Information by natrénování špičkového modelu vyžadovalo zapojit více než 10 000 čipů Huawei běžících nepřetržitě po celé týdny. Samotný Huawei na konferenci Huawei Connect ukázal plány na propojení až 15 488 čipů Ascend 960 v jednom opticky propojeném systému Atlas SuperPoD. Čím více čipů a kabelů ale v jednom trénovacím běhu spojíte, tím prudčeji roste spotřeba elektřiny i pravděpodobnost, že výpadek jediného uzlu shodí celý výpočet.
3. Výrobní kapacity a nedostatek pamětí HBM. Kvůli americkým exportním zákazům nemá čínský výrobce polovodičů SMIC přístup k nejmodernějším litografickým strojům EUV od nizozemského ASML. Čipy Ascend tak vznikají na starších 5nm až 7nm linkách: plocha výpočetního křemíku v pouzdru Ascend 950DT činí zhruba 800 mm² oproti 1 600 mm² u čipu Nvidia B300 vyráběného u tchajwanského TSMC. Ještě horší je situace u rychlých vrstvených pamětí HBM, bez nichž výpočetní jádra čekají naprázdno. Čínský výrobce CXMT sice letos spustil první malé série pamětí HBM3E, za jihokorejským SK Hynixem, Samsungem a americkým Micronem však zaostává o tři až pět let. Epoch AI odhaduje, že Huawei letos vyrobí přibližně 1,5 milionu čipů Ascend oproti 5,9 milionu čipů Nvidie. V přepočtu na celkový výpočetní výkon tak Huawei v roce 2026 vyprodukuje méně než 4 procenta kapacity Nvidie, a pokud by se do roku 2028 musel obejít bez zahraničních skladových zásob pamětí HBM, klesl by jeho podíl ke zhruba jednomu procentu.
Co čínská snaha o nezávislost znamená pro Česko a Evropu
Samotné servery s čipy Huawei Ascend 950 či chystanými Ascend 960 se do evropských ani českých datacenter nedostanou. Rotující předseda představenstva Huawei Eric Xu v září 2026 otevřeně potvrdil, že firma nemá dostatečnou výrobní kapacitu ani na uspokojení poptávky uvnitř Číny, a proto odložila plány na plnohodnotnou mezinárodní expanzi řady Ascend 900.
Pro české vývojáře, firmy i běžné uživatele má ale čínský pokus o hardwarovou soběstačnost přímý dopad. Modely rodiny DeepSeek, včetně DeepSeek-V4.1 Flash, jsou v Česku plně dostupné přes webové rozhraní, API i jako otevřené váhy a češtinu zvládají bez omezení. Pokud se DeepSeeku podaří přesunout nejen provoz, ale i samotný trénink budoucích modelů na domácí čínské čipy, přestane být jeho další vývoj rukojmím amerických exportních licencí. Pro evropský trh to znamená jediné: čínská konkurence si udrží schopnost vydávat levné otevřené modely a dál tlačit dolů ceny API u amerických gigantů, kteří zároveň hledají vlastní cesty mimo Nvidii, jako když OpenAI s Broadcomem nasadily vlastní inferenční čip Jalapeño.
Přestane teď DeepSeek úplně používat čipy od Nvidie?
Ne. Podle informací serveru The Information se DeepSeek čipů od Nvidie nevzdává a nadále se snaží získat přístup k jejím pokročilým procesorům pro trénink největších modelů. Spolupráce s Huawei má vytvořit domácí záložní i budoucí hlavní pilíř pro případ ještě tvrdších amerických sankcí, nikoliv okamžitě nahradit stávající trénovací clustery Nvidie.
Může jazyk TileLang využít i běžný vývojář mimo Čínu?
Ano. TileLang i navazující výpočetní knihovny DeepSeeku jsou uvolněné jako open source na GitHubu. Protože TileLang podporuje jak grafické karty Nvidia (přes CUDA), tak další akcelerátory, mohou ho využít i evropští a čeští vývojáři, kteří chtějí psát rychlá výpočetní jádra v syntaxi blízké Pythonu bez uzamčení k jedinému výrobci hardwaru.
Jak chce Huawei dohnat Nvidii, když nemá přístup k nejmodernějším výrobním strojům?
Krátkodobě to řeší spojováním tisíců čipů do obřích opticky propojených celků (SuperPoD) na úkor mnohem vyšší spotřeby elektřiny. Dlouhodobou sázkou Huawei pro rok 2030 je pak technologie vrstvení logických obvodů na sebe (LogicFolding), která má zvýšit hustotu tranzistorů i na starších výrobních procesech.
Zdroje: The Information (19. 10. 2026), Investing.com / Yahoo Finance, Epoch AI (Will Huawei catch up to Nvidia by 2030?), Tom's Hardware (TileLang a Ascend nástroje), Tom's Hardware (Huawei Ascend roadmapa) a GitHub repozitáře tile-ai/tilelang, DeepGEMM-Ascend, DeepEP-Ascend a FlashMLA.
