Tři cesty, jak spojit dva vstupy
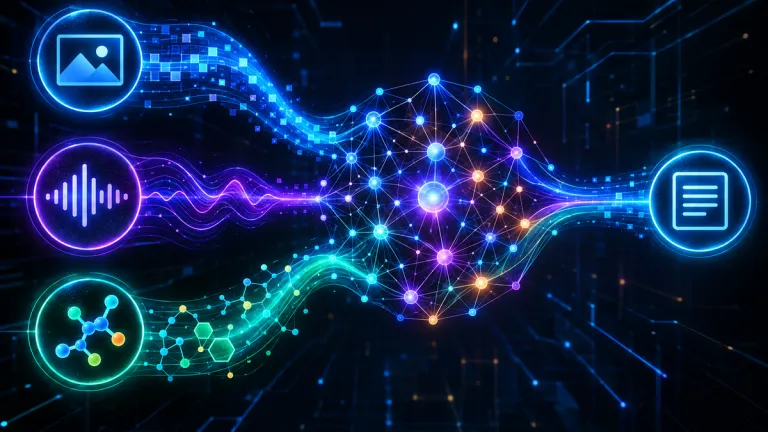
Výzkum se točí kolem jedné volby: kdy a jak propojit informaci z více modalit. Studie Joint, Decoupled, or Agent rozlišuje tři přístupy, které se liší tím, kde k propojení dojde. První je Joint. Dva enkodéry, tedy části sítě, které zpracují obraz a text, se předtrénovaly společně na párech obrázek-popisek. Už „mluví stejným jazykem", a na vašem úkolu stačí natrénovat jen malou spojku nad nimi. Druhý je Decoupled. Obrazový a textový enkodér se trénovaly samostatně, každý jinde. Teprve na vašem úkolu se nad nimi učí fusion head, malá síť, která oba výstupy slepí dohromady. Nikdo předem nezarovnal jejich vektorové prostory. Třetí je Agent. Do hry nevstupuje fusion head, ale velký jazykový model. Dostane instrukci, pár označených příkladů, text vzorku a číselné výstupy obou enkodérů a sám z nich složí odpověď. Nevidí přímo obrázek ani zvuk, jen jejich „překlad" do čísel. Přirovnání z běžného života: Joint je tým, který spolu léta trénuje. Decoupled jsou dva špičkoví specialisté z jiných firem, nad nimiž stojí nově najatý manažer. Agent je chytrý generalista, který si přečte zprávy od obou a rozhodne sám.Žádná metoda nedominuje
Autoři postavili všechny tři přístupy vedle sebe na 16 datasetech v pěti doménách: obraz a text, zvuk a text, medicína, molekuly a proteiny. Každý dataset navíc zkoušeli s různým počtem označených trénovacích příkladů, což dává dohromady 144 kombinací dataset-rozpočet. Výsledek podle průměrného užitku: Decoupled vyhrál 54 buněk, Agent 46 a Joint 44. Rozdíly jsou malé a žádný přístup nevládne celé tabulce. To je vlastně hlavní sdělení: univerzální vítěz neexistuje. Důležité je, že vše běží na veřejných checkpointech a zmrazených enkodérech. Trénuje se jen fusion head, ne celý model. Studie je proto reprodukovatelná i bez obřího GPU rozpočtu.Kdy vyhrává která metoda
Z dat vystupují tři vzory. Zaprvé, s rostoucím počtem označených dat se ScienceQA, MELD a MetMeme přesouvají od Agenta k fúzi. Při málo datech táhne Agent svou obecnou znalostí, při dostatku dat začne natrénovaná spojka vyhrávat. Zadruhé, u úloh otázka-odpověď vede Joint na čtyřech z pěti datasetů napříč všemi rozpočty. Společně předtrénované enkodéry mají náskok tam, kde se páruje otázka s kandidátem. Zatřetí, u klasifikace platí pravidlo, které dává smysl: čím lépe samotný enkodér obnoví štítek podle svých sousedů (měřeno přesností 5-NN), tím víc se preference kloní k Decoupled. Korelace je záporná a silná, Spearman ρ = −0,67 na osmi datasetech. Když už informace leží v jedné modalitě, není nutné ji mít předem zarovnanou.Jak poznat vítěze bez trénování tří modelů
Praktická otázka zní, jestli musíte zkoušet všechny tři přístupy. Autoři tvrdí, že ne. Navrhli dvoustupňovou kaskádu, která nejprve rozhodne Agent versus fúze, pak Joint versus Decoupled. Využívá geometrii reprezentací, diagnostiku s dohledem, shodu mezi textem a štítkem a metadata o úkolu a rozpočtu. V testu leave-one-group-out kaskáda trefila vítěze v 71,4 % buněk, zatímco routing jen podle metadat dosáhl 54,2 %. Průměrná relativní lítost (regret) klesla z 0,057 na 0,028. Kaskáda tedy nejen lépe tipuje, ale když se splete, ztratí méně. Má to svoje limity, které autoři neskrývají. 71,4 % není stoprocentní. A počítaný „užitek" nezahrnuje náklady na provoz. Agent s velkým jazykovým modelem je při běhu dražší než malá fusion head, což výzkum ve výpočtech záměrně nechává stranou. Kdo optimalizuje na cenu, musí si čísla přepočítat sám.Proč to zajímá i české týmy
Studie nestaví žádný placený produkt. Pracuje s veřejnými modely a ukazuje postup, který může zopakovat každý datový tým. Pro české firmy, které nemají rozpočet na trénování modelů od nuly, z toho plyne jednoduchý závěr: multimodální systém postavíte tak, že si vyberete existující enkodéry a natrénujete jen tenkou spojku nad nimi. Drahá část, tedy předtrénování velkých modelů, už je hotová a volně dostupná. Druhý závěr se týká volby přístupu. Pokud vám chybí označená data, začněte agentovým přístupem s LLM, který táhne svou obecnou znalost. Jakmile data máte, přejděte k fúzi. A u úloh s otázkami a odpověďmi se vyplatí sáhnout po společně předtrénovaném páru enkodérů. Přesná diagnostika z článku je zatím popsaná jen v metodologii, bez veřejně vydaného kódu, takže kdo ji chce použít, musí si ji přepsat podle popisu v práci. Shrnutí, jak to vidím já: není to žádný velký skok, ale užitečný rozcestník. Až budete příště spojovat obraz se zvukem nebo molekulu s popisem, nemusíte zkoušet tři slepé uličky. Článek dá tip, kde začít. Druhý pohled na stejné výsledky nabízí i přehled ArXivSignals.Co znamená „zmrazený enkodér"?
Je to část neuronové sítě, která zpracuje vstup na číselný vektor, ale při trénování na vašem úkolu se její váhy nemění. Dotrénovává se jen malá vrstva nad ní. Díky tomu je celý proces rychlý a levný, protože se nemusí učit celý velký model znovu.
Proč Agent prohrává, když máte hodně označených dat?
Agent spoléhá na obecnou znalost jazykového modelu a na výstupy enkodérů, které vidí jen zprostředkovaně. S mnoha označenými příklady dokáže fusion head natrénovaný přímo na vašem úkolu vytěžit z dat víc, protože se učí přesně na cílovou úlohu.
Je agentový přístup dražší na provoz?
Ano. U Agentu se při každém dotazu spouští velký jazykový model, což stojí víc výpočtu než jedno dopředné projití malou fusion head. Studie náklady na nasazení do měřeného užitku nezapočítává, uvádí to jako samostatnou věc, kterou je potřeba posoudit zvlášť.
