
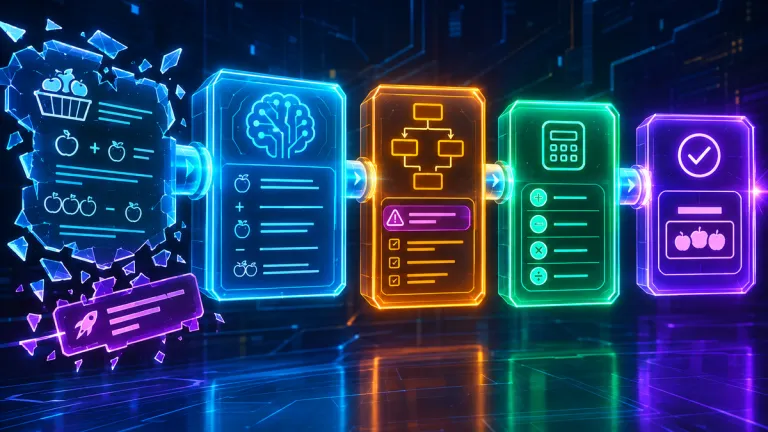
Čtyři kroky místo černé skříňky
Studie A Four-Stage Decomposition of Word-Problem Solving and Mechanistic Fragility in LLM Math Reasoning od Zhongdi Qu a Carly P. Gomes z Cornellu (přijatá na konferenci Findings of EMNLP 2026) se snaží odpovědět na starý spor. Jedna skupina výzkumníků tvrdí, že modely „matematiku“ jen předstírají a ve skutečnosti porovnávají vzorce v textu. Druhá říká, že model opravdu přemýšlí v krocích. Cornellští autoři obojí sjednocují: model ano, myslí po krocích, ale tenhle řetězec má jedno slabé místo, které se dá přesně pojmenovat.
Klíčový nástroj se jmenuje mechanistická interpretovatelnost — jde o to nahlédnout dovnitř modelu a zjistit, co dělají jednotlivé vrstvy, ne jen co model odpoví navenek. Autoři ho použili na Llama-3.3-70B-Instruct, který má 80 vrstev, a výsledky ověřili i na menších modelech Qwen-2.5-14B a Gemma-2-9B.
Zjistili, že řešení slovní úlohy se uvnitř modelu skládá ze čtyř po sobě jdoucích fází. Každá fáze přepíše vnitřní reprezentaci problému do jiné podoby, a to v konkrétním rozmezí vrstev:
- Abstrakce schématu — model odhodí povrchní detaily příběhu (jména, kachny, trh) a ponechá si jen kostru vztahů.
- Plánování operací — určí, jaké početní úkony (sčítat, odčítat, násobit) a v jakém pořadí je potřeba udělat.
- Navázání čísel — do připraveného plánu dosadí konkrétní hodnoty ze zadání.
- Výpočet — samotné spočítání a vypsání výsledku.
Hranice mezi fázemi našli na vrstvách 22, 36, 40 a 80, a to třemi nezávislými metodami, které se shodly. Zní to akademicky, ale představte si to jako výrobní linku: jedno stanoviště vytáhne z popisu jen to podstatné, další vymyslí postup, další nasadí čísla a poslední dopočítá.
Janet, kachny a čtyři patra výpočtu
Autoři to ilustrují na klasické úloze. Janetiny kachny snášejí 16 vajec denně. Tři Janet sní k snídani, čtyři použije na muffiny a zbytek prodá na trhu po 2 dolarech za kus. Kolik denně utrží?
Model to v hlavě rozdělí přesně na ty čtyři kroky. Nejdřív si z příběhu vytáhne abstraktní schéma: „něco se vyrobí, část se spotřebuje, zbytek se prodá za cenu X“. Pak naplánuje operaci: (16 − 3 − 4) × 2. Teprve pak dosadí čísla a nakonec dopočítá 9 × 2 = 18 dolarů. Klíčové je, že každá fáze má svůj vlastní mezivýsledek a každá může selhat zvlášť — a chyba se pak přenese do dalších kroků.
To je rozdíl oproti staršímu, dvoufázovému pohledu: vědci dřív viděli jen „nejdřív abstrakce, pak počítání“. Tady se ukazuje, že mezi tím je ještě samostatný krok plánování operací — a právě ten je nejzranitelnější.
Jedna věta navíc a model se sesype
Slabé místo odhalil experiment s takzvanými „NoOp“ větami. Do zadání se vloží věta, která je pravdivá, ale pro výpočet nepodstatná — třeba „Janet má také dvě kočky“. Zdravý rozum ji prostě ignoruje. Jenže model ne: podle dřívější práce Mirzadeha a kolegů (2025) dokáže jedna taková věta srazit přesnost až o 65 procent. Až dosud ale nikdo nevěděl, kde se to uvnitř modelu láme.
Cornellský tým to lokalizoval. Chyba nevzniká při čtení zadání ani při dosazování čísel, ale přesně ve fázi plánování operací, kolem vrstvy 36. Distraktor tam zahltí konkrétní sadu „hlav pozornosti“ — malých čtecích mechanismů, kterými model vybírá, na která slova a vztahy se v textu zaměřit. Část z nich tlačí model směrem ke správnému plánu, část ho stahuje k tomu špatnému, a distraktor váhu vychýlí na špatnou stranu.
Důkaz z obou stran
Že jde opravdu o tenhle konkrétní okruh hlav, ukázali výzkumníci dvěma směry. Když tyto hlavy vypnuli na příkladech, které model běžně řeší správně, přesnost se propadla z jedničky na 0,06 až 0,47 podle toho, kterou část vypnuli — zatímco vypnutí náhodných hlav mimo danou oblast přesnost nechalo nad 0,98. A naopak: když na pokažených úlohách zesílili signál těch hlav, které bojují proti špatnému plánu, podařilo se jim zachránit zhruba polovinu selhání — přesnost z nuly vyskočila na 0,51.
Nejpikantnější na tom je, že šlo o jediné globální číslo: žádný trénink, žádné dodatečné učení, jen se všem dotčeným hlavám zdvojnásobil jejich výstup. A když pak analyzovali, jaké chyby model dělá po vypnutí hlav, v 91 procentech případů šlo právě o selhání plánování operací — model přečetl zadání správně, ale použil špatnou operaci nebo žádnou. To je silný důkaz, že tato fáze je skutečný, samostatný článek řetězu, ne šum.
Proč na tom záleží
Praktický dopad je dvojí. Zaprvé to vysvětluje zkušenost, kterou zná každý, kdo AI reálně používá: model spočítá správně, přidejte do promptu jednu větu navíc, a najednou je z toho nesmysl. Nejde o náhodu ani o „hloupost“, ale o konkrétní, opakovatelnou mechaniku. Zadruhé to dává naději, že se tahle křehkost dá opravit cíleně — a hlavně to ukazuje, kde oprava musí zabrat.
Pro evropské čtenáře je tu jeden důležitý detail: všechny tři testované modely (Llama, Qwen, Gemma) jsou otevřené váhy, které lze provozovat na vlastní infrastruktuře. Kdo v EU staví službu na jazykovém modelu a musí plnit požadavky na spolehlivost a přesnost podle AI Act, ten se s touhle křehkostí setká dřív nebo později — a teď má aspoň mapu, kde hledat. Kód i data jsou volně na GitHubu.
Ještě jeden závěr stojí za zdůraznění. Autoři ověřili, že stejná čtyřfázová struktura se objevuje i u jiných typů úloh — mimo matematiku i u otázek vyžadujících spojit víc informací. Pokud se potvrdí, že „čtyři kroky“ jsou obecný způsob, jakým velké jazykové modely zpracovávají úlohy, mění to pohled na celý obor: místo jedné neprůhledné černé skříňky tu máme sérii pojmenovatelných stanic, z nichž každou lze testovat a opravovat samostatně.
Proč model nezvládne ignorovat větu, která je zjevně nepodstatná?
Protože při plánování operací se model spoléhá na vzorce v textu. Distraktor změní rozložení signálů v malé sadě „hlav pozornosti“, které váží, která slova jsou pro řešení důležitá. Jde o mechanický efekt, ne o nepochopení — proto se dá obejít zesílením protichůdného signálu, aniž by se model znovu trénoval.
Týká se to i ChatGPT nebo jiných komerčních modelů?
Studie testovala otevřené modely Llama-3.3-70B, Qwen-2.5-14B a Gemma-2-9B, takže závěr se vztahuje přímo na ně. Křehkost vůči distraktorům je ale doložený jev napříč velkými jazykovými modely obecně, takže podobné chování lze čekat i u uzavřených modelů, byť u nich ho nelze zvenku tak přesně lokalizovat.
Znamená to, že AI v matematice není spolehlivá?
Ne. Na čistých slovní úlohách modely počítají velmi přesně. Problém nastává konkrétně tehdy, když zadání obsahuje nepodstatnou, ale související informaci navíc. Pro praxi to znamená držet zadání stručné a jednoznačné — a tam, kde na přesnosti záleží, výsledek nezávisle zkontrolovat.
