
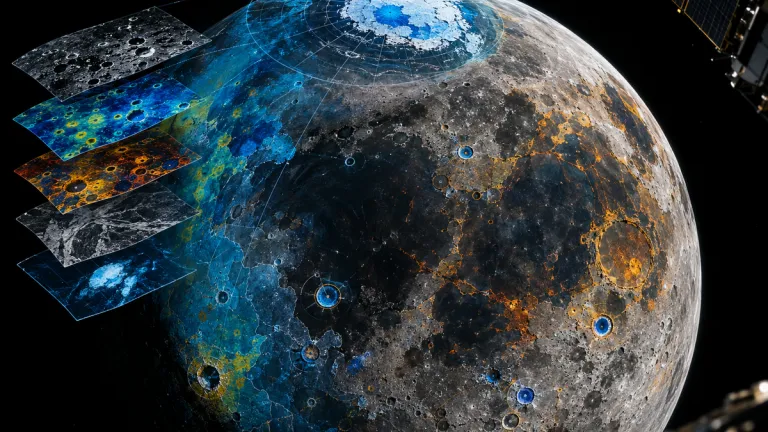
Model pro měsíční data z více přístrojů
NASA a IBM vytvořily NASA-IBM Lunar Foundation Model pro dálkový průzkum Měsíce. Jeho úkolem není generovat text ani odpovídat na otázky jako jazykový model. Pracuje s obrazovými, topografickými, tepelnými, radarovými a dalšími vědeckými daty.
To je důležité proto, že Měsíc nemá jednu univerzální mapu. Jedna družice zachytí povrch ve vysokém rozlišení, jiný přístroj měří gravitaci a další sleduje tepelné nebo minerální vlastnosti. Výzkumník pak musí tyto vrstvy spojit a hledat vztahy mezi nimi. Model funguje jako společný výchozí bod, ze kterého lze řešit několik různých úloh.
NASA a IBM jej zveřejnily pod licencí Apache 2.0. Váhy modelu jsou dostupné na Hugging Face, zdrojový kód a nástroje pro další použití jsou na GitHubu NASA IMPACT. Přiložené konfigurace jsou napojené na open-source nástroj TerraTorch, který slouží k trénování a vyhodnocování modelů pro obrazová a ge prostorová data.
([newsroom.ibm.com](https://newsroom.ibm.com/2026-09-10-ibm-and-nasa-release-open-source-ai-model-to-support-lunar-exploration))Co se model naučil z 17 let pozorování
Trénink vychází především z dat družice Lunar Reconnaissance Orbiter, která Měsíc pozoruje od roku 2009. Soubor doplňují měření z misí GRAIL, Lunar Prospector a japonské SELENE. Dohromady jde téměř o 2 miliony snímkových balíčků.
Konkrétně dataset obsahuje 1 000 113 snímků z kamery NAC v rozlišení přibližně 1 metr na pixel a 963 609 multispektrálních snímků z kamery WAC v rozlišení přibližně 100 metrů na pixel. Nejde tedy o jednu obří fotografii Měsíce. Data jsou připravená jako vzájemně zarovnané vrstvy, které popisují stejná místa různými způsoby.
Podle technické dokumentace model pracuje s 11 datovými modalitami a dvěma měřítky. Slovo modalita zde znamená typ vstupu, například obraz, výškový model, sklon terénu nebo teplotní údaj. Model se učí, že určitý tvar povrchu může souviset s konkrétními hodnotami gravitace, osvětlení nebo teploty.
Architektura vychází z modelu Vision Transformer a byla upravena pro lunární dálkový průzkum. Součástí je také práce s různými rozlišeními, takže stejný základ lze využít pro detailní snímky i širší mapové vrstvy. Výzkumníci při přizpůsobení používají také LoRA, tedy metodu, která mění jen menší část parametrů modelu místo kompletního přeškolení.
([research.ibm.com](https://research.ibm.com/blog/nasa-ibm-lunar-foundation-model))Led, krátery a vulkanická minulost
Odhad výskytu vodního ledu
Jednou z hlavních úloh je odhad, kde by se v polárních oblastech mohl nacházet vodní led. Trvale zastíněné krátery jsou obtížně pozorovatelné, protože do nich téměř nedopadá sluneční světlo. Model proto nespoléhá pouze na běžnou fotografii. Kombinuje například teplotu, sklon terénu, orientaci svahu a hloubku, ve které by mohl být led stabilní.
V testu zaměřeném na takzvanou ice prospectivity snížil NASA-IBM model chybu odhadu až o 22 procent proti modelu SwinV2-B, který byl trénovaný pro podobnou úlohu. Jde o výsledek konkrétního experimentu, nikoli o důkaz, že model umí led na Měsíci přímo potvrdit. Výstup označuje oblasti vhodné pro další vědecké zkoumání.
Automatické hledání kráterů
Krátery vědcům pomáhají určovat stáří a geologický vývoj povrchu. Jejich mapování má význam také při plánování budoucích přistání, protože detailní mapa může upozornit na svahy, balvany a další rizikové prvky.
Při rozlišení kolem 1 metru na pixel dosáhl model srovnatelné přesnosti jako specializovaný SwinV2-B. Při rozlišení 100 metrů na pixel jej podle zveřejněných výsledků překonal téměř o 19 procent, přestože byl trénován pouze na polovině dostupných označených dat.
Stopy dávného vulkanismu
Třetí oblastí jsou nepravidelné měsíční lávové útvary známé jako irregular mare patches. Jejich přesné stáří a původ zůstávají předmětem výzkumu. Model dokázal jejich rozsah v testu určit o 3 procenta lépe než srovnávaný specializovaný model. Autoři zároveň uvádějí, že podobné výsledky dosáhl s menšími nároky na dodatečné přizpůsobení.
([newsroom.ibm.com](https://newsroom.ibm.com/2026-09-10-ibm-and-nasa-release-open-source-ai-model-to-support-lunar-exploration))Otevřený model má praktické limity
Dostupnost modelu zdarma je pro vědecké týmy a univerzity v Česku i Evropské unii zajímavá hlavně kvůli možnosti vlastního výzkumu. Není nutné kupovat přístup k placenému API. Zájemce si může stáhnout váhy, data a připravené konfigurace z veřejných repozitářů.
To ovšem neznamená, že model poběží na běžném notebooku. Už samotné předtrénování zabralo přibližně 1 100 GPU-hodin na 16 grafických kartách Nvidia H100. Provoz hotového modelu může být méně náročný než jeho trénink, ale stále jde o nástroj pro výzkumné pracoviště, nikoli o aplikaci pro domácí počítač.
Dalším omezením je rozsah zveřejněného kódu. GitHub obsahuje balíčky pro inferenci, fine-tuning a vyhodnocování, samotný předtrénovací kód však součástí repozitáře není. Výzkumník tak dostane hotový základ a nástroje k jeho úpravě, nikoli kompletní recept na zopakování celého tréninku od prvního kroku.
Model také není lokalizovaný do češtiny. U této technologie to ale není zásadní překážka, protože nejde o jazykovou službu. Pracuje s vědeckými daty, mapami a snímky. Pro českého uživatele je důležitější dostupnost repozitářů, licence Apache 2.0 a možnost použít model v evropském výzkumném prostředí.
Proč je důležitý společný základ
Dosavadní postup často vypadal tak, že se pro každou úlohu vytvořil samostatný model. Jeden hledal krátery, druhý odhadoval led a třetí analyzoval vulkanické útvary. NASA-IBM Lunar Foundation Model tento postup mění na praktičtější pracovní základ. Výzkumník může začít s předtrénovaným modelem a upravit jej pro konkrétní dataset.
Podobný přístup se používá také u modelů pro pozorování Země a vesmírného počasí. Rozdíl spočívá v tom, že lunární model vznikl přímo z dat Měsíce a současně kombinuje více rozlišení i měřicích metod. Technická zpráva a benchmarky jsou zveřejněné spolu s modelem, takže další týmy mohou výsledky porovnávat na stejných úlohách.
Pro vědu je podstatné také to, že model není uzavřený produkt s výsledkem dostupným pouze přes webové rozhraní. Výzkumníci mohou zkontrolovat vstupy, upravit trénování a použít vlastní data. To je méně pohodlné než kliknout na hotovou aplikaci, ale vhodnější pro práci, kde je nutné znát původ každého výstupu.
NASA-IBM Lunar Foundation Model je tedy hlavně infrastruktura pro další výzkum. Umí zpracovat velké množství různorodých měsíčních dat, pomáhá s mapováním povrchu a v publikovaných testech překonal nebo dorovnal specializované modely. Výsledky ale stále vyžadují vědecké ověření a model sám o sobě nepotvrzuje, že se v konkrétním kráteru skutečně nachází led.
FAQ
Je NASA-IBM Lunar Foundation Model dostupný zdarma?
Ano. Váhy modelu, doprovodný kód a související dataset jsou veřejně dostupné. Model je vydaný pod licencí Apache 2.0, u jednotlivých datových sad je nutné zkontrolovat jejich konkrétní licenční podmínky.
Může model používat běžný uživatel bez znalosti programování?
Prakticky ne. Jde o výzkumný model určený pro práci s obrazovými a geospatialními daty. Ke stažení a použití jsou potřeba Python, vhodné výpočetní prostředí a znalost nástrojů pro strojové učení.
Dokáže model potvrdit, že je na Měsíci voda?
Ne přímo. Model odhaduje, které oblasti mají vlastnosti odpovídající možnému výskytu vodního ledu. Výsledek slouží k výběru míst pro další analýzu a nenahrazuje přímé měření nebo odběr vzorků.
Původní zpráva na The Decoder | technické vysvětlení IBM Research | technická zpráva na arXiv
