
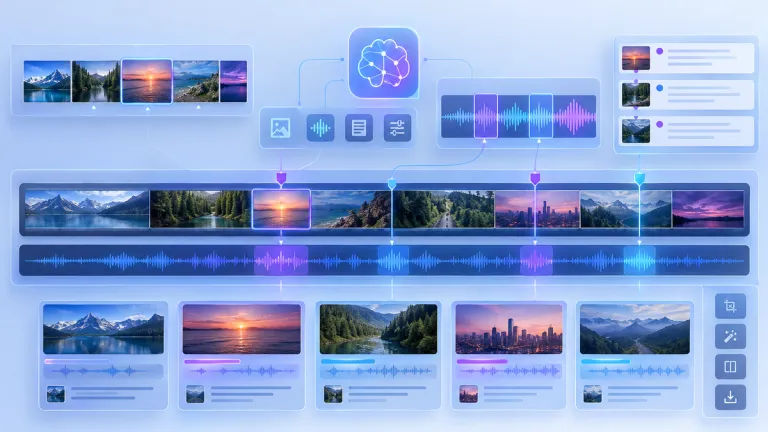
Alibaba 18. září 2026 představila model Qwen3.8-Omni-Flash, který v jednom požadavku zpracuje text, obrázky, zvuk i video. Jeho hlavní novinkou není jen multimodální vstup, ale způsob práce s dlouhými záznamy: místo slepého procházení celého souboru hledá části, které souvisejí s položenou otázkou. Model je dostupný jako hosted API přes QwenCloud, Alibaba Cloud Model Studio a Qwen Studio. Otevřené váhy při uvedení zveřejněny nebyly.
Model, který nejdřív hledá důležité části
U dlouhého videa bývá problém jednoduchý: odpověď může být ukrytá ve třech minutách záznamu, který trvá dvě hodiny. Běžný postup spočívá v tom, že systém postupně projde celý soubor, vytvoří si jeho reprezentaci a teprve potom odpovídá. To je přesné, ale může to znamenat zbytečně vysokou spotřebu výpočetního výkonu a tokenů.
Qwen3.8-Omni-Flash používá podle popisu týmu Qwen jiný přístup. Začne otázkou uživatele a následně si vytipuje části obrazu a zvuku, které mohou obsahovat odpověď. V několika krocích se zaměřuje na relevantní úseky a teprve z nich skládá výsledek. Pro uživatele to může znamenat například rychlejší hledání konkrétního momentu v přednášce, schůzce nebo výukovém videu.
V testu OmniVideoBench uvádí Qwen nárůst přesnosti z 63,4 na 67,8 bodu. Současně klesla spotřeba tokenů ze 145 736 na 79 117, tedy přibližně o 45,7 procenta. Jde však o výsledek prezentovaný samotným výrobcem, nikoli o nezávislé měření. Podrobnosti testu a použité hodnoty zveřejnil MarkTechPost.
Rozumí textu, obrazu, audiu i videu
Model přijímá čtyři typy vstupu: text, obrázky, audio a video. Výstupem je text. To je důležité omezení, protože Qwen3.8-Omni-Flash sám o sobě negeneruje mluvenou odpověď. Pokud vývojář potřebuje hlasový výstup, dokumentace Alibaba Cloud odkazuje na samostatný model Qwen3.5-Omni.
QwenCloud uvádí kontextové okno o velikosti 1 milion tokenů. V praxi je ale rozděleno na maximálně 991 tisíc tokenů pro vstup a 131 tisíc tokenů pro výstup. Pro uvažování je uveden limit 262 tisíc tokenů. Velké kontextové okno umožňuje pracovat s rozsáhlým materiálem, samo o sobě však nezaručuje, že model správně pochopí každou část knihy, videa nebo nahrávky.
Podle dokumentace lze přes URL poslat video o délce až dvě hodiny a velikosti do 2 GB. Audio může mít až tři hodiny. Vstupní audio podporuje 113 jazyků a dialektů. Mezi podporovanými oblastmi je také němčina a další evropské jazyky, ovšem z dostupných podkladů nelze potvrdit samostatnou úroveň kvality pro češtinu. Češtinu proto nelze označit za garantovanou specializaci modelu, přestože obecná podpora vícejazyčného audia může být pro české uživatele relevantní.
Model je dostupný v šesti regionech: Peking, Singapur, Hongkong, Tokio, Frankfurt a Virginie. Pro firmy v Evropské unii je důležitá především dostupnost regionu Frankfurt. Konkrétní právní posouzení práce s osobními údaji ale závisí na nastavení služby, smluvních podmínkách a typu zpracovávaného obsahu.
Nejde jen o analýzu, model umí volat nástroje
Qwen3.8-Omni-Flash podporuje takzvané function calling. Model tedy nemusí pouze odpovědět textem, ale může předat požadavek externí funkci nebo aplikaci. V kombinaci s multimodálním vstupem to může vypadat například tak, že analyzuje nahrávku porady, vytáhne úkoly, připraví strukturovaný seznam a předá ho do firemního systému.
Podporováno je také webové vyhledávání, strukturované výstupy, dávkové zpracování a ukládání kontextu do cache. API pracuje s protokoly DashScope i OpenAI a podporuje rozhraní Chat Completions a Responses. Pro vývojáře to snižuje množství nového kódu, pokud už používají OpenAI SDK nebo podobný způsob volání modelů.
Myšlení je podle dostupných informací zapnuté ve výchozím nastavení. Parametr reasoning_effort je nastaven na hodnotu xhigh, přičemž lze uvažování vypnout nastavením none. Pro běžné shrnutí schůzky nemusí být nejvyšší úroveň uvažování vždy potřebná, takže možnost volby může pomoci s náklady a rychlostí.
Výsledky vypadají slibně, ale nejsou nezávislé
Qwen uvádí, že v průměru zlepšil výsledky ve 29 hodnoceních o více než 25 procent proti předchozímu modelu Qwen3.5-Omni-Plus. V benchmarku WildClawBench-MM má být zlepšení 36,5 bodu a v AgenticVBench 22,3 bodu. UniClawBench dosáhl skóre 69,6. U testů LongAudioSpan a OmniVideoBench Qwen uvádí zlepšení o 8,3, respektive 9,6 bodu.
Výrobce současně tvrdí, že v audiovizuálních úlohách je výkon blízko modelu Gemini 3.8 Flash a v celkovém zpracování audia jej překonává. Tato tvrzení je nutné číst opatrně. Dostupné výsledky pocházejí z materiálů Qwen a při zveřejnění nebyla k dispozici nezávislá reprodukce. Z čísel proto nelze vyvodit, že je model obecně lepší než Gemini, GPT nebo Claude. Benchmark ukazuje výkon v konkrétním testu, nikoli kvalitu při každém reálném použití.
Pro srovnání cen je Qwen3.8-Omni-Flash výrazně levný na vstupu: QwenCloud uvádí 0,15 dolaru za milion vstupních tokenů a 0,47 dolaru za milion výstupních tokenů. Implicitní zásah do cache stojí 0,016 dolaru za milion tokenů. Cena se týká API a neznamená, že je služba bezplatná pro všechny uživatele Qwen Studio.
Podle údajů týmu Qwen klesla cena za hodinu audio vstupu o více než 98 procent a cena za hodinu audiovizuálního vstupu o více než 93 procent oproti předchozímu Qwen3.5-Omni-Plus. Ani tato čísla ale nelze bez další metodiky chápat jako univerzální cenu konkrétního videa. Výsledný účet závisí na délce souboru, zvoleném zpracování, počtu opakovaných dotazů a množství výstupu.
Pro koho má model smysl
Nejzajímavější využití vidím u lidí, kteří pracují s velkým množstvím záznamů. Může jít o automatické vyhledání témat v rozhovorech, zápisy z porad, označení důležitých momentů ve školení nebo orientaci v dlouhém webináři. Vývojář může model napojit na vlastní aplikaci a nechat jej po analýze zavolat další nástroj.
Qwen zveřejnil také knihovnu Qwen-MM-Plugins pod licencí Apache-2.0. Nabízí například vytvoření audiovizuální paměti dlouhého videa, převod výukového videa do ilustrovaného PDF nebo nástroje pro práci s filmem a hudebním videem. Projekt lze instalovat jako dovednost nebo volitelný MCP server. Zdrojový kód je dostupný na GitHubu Qwen.
Pro domácího uživatele zatím nejde o model, který by jednoduše stáhl do notebooku a provozoval lokálně. Qwen3.8-Omni-Flash je při uvedení dostupný jako cloudové API a otevřené váhy nebyly oznámeny. Při práci s rodinnými videi, interními poradami nebo citlivými dokumenty je proto vhodné předem zkontrolovat podmínky zpracování dat a neposílat do služby obsah bez souhlasu dotčených osob.
Praktický závěr
Qwen3.8-Omni-Flash posouvá důraz od pouhého rozpoznání obrazu a zvuku k aktivnímu hledání důkazů v dlouhém záznamu. To je užitečnější než samotný údaj o milionovém kontextu, protože kvalitu práce s videem určuje také to, zda model dokáže najít správný okamžik.
Pro vývojáře a firmy, které potřebují analyzovat audio nebo video, stojí model za vyzkoušení. Výhodou je nízká zveřejněná cena API, podpora nástrojů a evropský region ve Frankfurtu. Pro běžné uživatele je ale důležité počítat s tím, že jde o cloudovou službu, výstup je pouze textový a tvrzení o výkonu zatím vycházejí především z interních testů Qwen. Aktuální technické limity a podporované regiony uvádí dokumentace Alibaba Cloud.
FAQ
Umí Qwen3.8-Omni-Flash odpovědět hlasem?
Ne. Tento model přijímá text, obrázky, audio a video, ale vrací text. Pro generování mluveného výstupu Alibaba Cloud odkazuje na samostatný model Qwen3.5-Omni.
Lze Qwen3.8-Omni-Flash provozovat na vlastním počítači?
Při uvedení nebyly zveřejněny otevřené váhy modelu. Dostupná je cloudová varianta přes QwenCloud, Alibaba Cloud Model Studio a Qwen Studio, takže lokální provoz z oznámených možností nevyplývá.
Je Qwen3.8-Omni-Flash vhodný pro české nahrávky?
Model podporuje audio ve 113 jazycích a dialektech, ale dostupné podklady nepotvrzují samostatnou garanci kvality pro češtinu. České nahrávky je proto vhodné nejprve otestovat na vlastních datech.
