Indie posílá AI za daty. Citlivé informace nemusí opouštět nemocnice
Indie zavedla rámec DEPA for AI Training, ve kterém model putuje do zabezpečeného prostředí s daty. Cílem je trénovat místní AI bez volného předávání zdravotních, bankovních a státních záznamů.
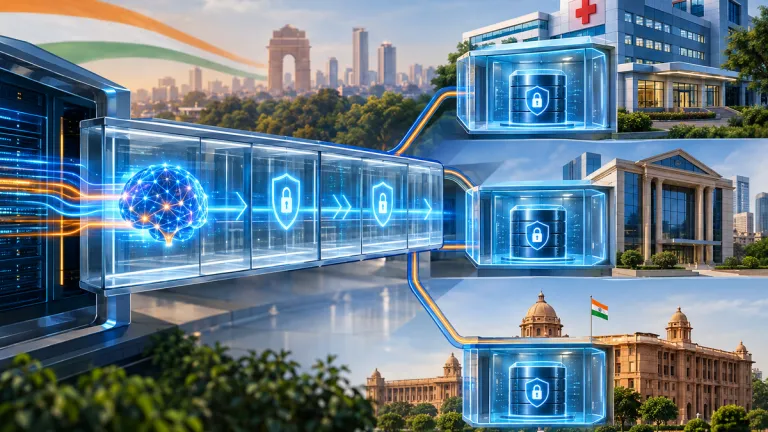
Indie mění směr práce s trénovacími daty
Indické ministerstvo elektroniky a informačních technologií MeitY představilo finální příručku DEPA for AI Training 31. října 2026 v Bengalúru. Na přípravě se podílela také nadace iSPIRT. Dokument popisuje technický a právní rámec pro sdílení dat při vývoji umělé inteligence.
Základní myšlenka je jednoduchá. Nemocnice, banka nebo úřad neposkytnou své databáze vývojáři k volnému stažení. Výpočetní infrastruktura a model se přesunou do prostředí, kde jsou data uložená. Model tam provede výpočty, naučí se potřebné vzorce a ven by měly putovat pouze povolené výsledky.
Indický vědecký poradce vlády Ajay Kumar Sood tento princip shrnul slovy, že „model putuje za daty, nikoli data za modelem“. Formulace zní trochu jako logistika pro robotický vysavač, v praxi však řeší jeden z největších problémů současného vývoje AI. Modely potřebují velké a různorodé datové soubory, jejich vlastníci ale často nemohou nebo nechtějí předat kompletní databáze třetí straně.
Podrobnosti zveřejnilo indické tiskové informační středisko a samotný rámec DEPA for AI Training.
Jak má DEPA fungovat
Systém rozděluje účastníky do několika rolí. Poskytovatelé trénovacích dat mohou být nemocnice, banky, státní úřady nebo jiné instituce, které data vytvářejí a spravují. Na druhé straně stojí spotřebitelé dat, tedy výzkumné týmy, firmy, startupy nebo vývojáři AI.
Mezi nimi má fungovat datová výměnná platforma. Ta nabídne zabezpečené prostředí, ve kterém lze data zpracovávat bez toho, aby je vývojář získal v původní podobě. Přístup k výpočtům mají řídit elektronické smlouvy a strojově čitelná pravidla.
To je důležitý rozdíl proti běžnému modelu spolupráce. Dnes firma často data exportuje, nahraje je do cloudu a teprve potom řeší, zda byl přístup dostatečně omezený. U DEPA se má oprávnění stát součástí samotné infrastruktury. Systém může například určit, jaký typ výpočtu je povolený, kolik dat lze zpracovat nebo zda je možné výsledek stáhnout.
Rámec počítá také s takzvanými Secure Data Environments. Jde o hardwarově chráněná výpočetní prostředí, ve kterých mají data zůstat izolovaná i během zpracování. Aktivity uvnitř mají být neměnně zaznamenané pro pozdější audit.
Další vrstvou je diferenční ochrana soukromí. Ta do výstupů přidává řízený statistický šum, aby model dokázal pracovat s obecnými vzorci, ale nemohl jednoduše odvodit údaje konkrétního člověka. Nejde o kouzelnou gumu na osobní data. Správné nastavení ochrany stále závisí na typu databáze, účelu modelu a zvoleném rozpočtu soukromí.
Zdravotnictví, banky a školy
Indická vláda chce rámec využít hlavně v oblastech, kde jsou data současně cenná i citlivá. Ve zdravotnictví jsou záznamy pacientů rozdělené mezi nemocnice, laboratoře a další instituce. Pokud by se daly bezpečně spojit, mohly by sloužit pro vývoj diagnostických nebo výzkumných modelů bez vytvoření jedné centrální databáze všech pacientů.
U financí má DEPA pomoci s modely pro hodnocení úvěrových rizik. Indie odhaduje úvěrový deficit u mikropodniků a malých a středních firem na 20 až 25 bilionů rupií (v přepočtu zhruba 5,5 až 7 bilionů korun, respektive 240 až 300 miliard dolarů). Bezpečnější práce s bankovními daty by mohla bankám umožnit přesnější posuzování žadatelů, kteří nemají dlouhou úvěrovou historii.
Oficiální dokument uvádí také možnost rozšířit formální přístup k úvěrům až pro 400 milionů nedostatečně obsloužených jednotlivců a malých firem. Jde o odhad potenciálního dopadu, nikoli o výsledek už proběhlého nasazení.
Vzdělávání je další oblastí, kterou dokument zmiňuje. Indie má přibližně 250 milionů studentů a chce využít data pro personalizované vzdělávání nebo přenositelné záznamy o dovednostech. Takový systém by mohl spojovat údaje z různých institucí, aniž by každá škola dostala přístup ke všem původním záznamům.
Výpočetní infrastruktura zůstává součástí plánu
Bez výpočetního výkonu se žádný bezpečný datový rámec sám od sebe nerozběhne. Indie proto rozvíjí vlastní AI infrastrukturu. Podle vládního programu IndiaAI Mission je pro indický ekosystém zpřístupněno 38 000 GPU s dotovanou průměrnou sazbou kolem 65 rupií za GPU-hodinu (přibližně 18 korun nebo 0,77 dolaru za hodinu).
To má význam hlavně pro startupy, výzkumníky a menší firmy, které by jinak musely citlivá data posílat do zahraničních cloudů nebo financovat vlastní výpočetní cluster. DEPA navíc počítá s tím, že datové výměnné platformy mohou nabídnout GPU infrastrukturu jako službu.
Indie odhaduje, že bezpečnější zpřístupnění dat může do roku 2030 odemknout až 500 miliard dolarů přidané hodnoty pro tamní ekonomiku. Toto číslo pochází z vládního rámce a jde o odhadovaný potenciál, nikoli o současný příjem nebo garantovaný výsledek.
Datová suverenita místo volného exportu
Za projektem není jen ochrana soukromí. Indie chce také podporovat modely trénované na místních datech. Zahraniční poskytovatelé AI mohou mít dostatek dat pro obecné úlohy, jejich modely však nemusí dobře zachytit indické jazyky, místní právní pravidla nebo specifika zdravotnictví a financí.
MeitY v říjnu upozornilo na rizika přesunu citlivých dat do zahraničních proprietárních systémů. DEPA má proto zapadat do širší strategie datové suverenity a do indického zákona DPDP o ochraně osobních údajů. Horní hranice sankce za neoprávněné nakládání s daty a porušení ochrany soukromí podle indického zákona DPDP dosahuje až 2,5 miliardy rupií (v tradičním indickém vyjádření 250 krorů rupií, kde jeden kror představuje 10 milionů), což v přepočtu činí zhruba 700 milionů korun.
Technická architektura má navazovat na indický koncept India Stack, tedy na soubor digitálních služeb a veřejných infrastruktur, které stát používá v platbách, identitě nebo sdílení finančních údajů. DEPA se snaží podobný princip přenést do trénování AI.
Co může projekt brzdit
DEPA zatím není univerzální platforma, do které by se mohl přihlásit libovolný vývojář a okamžitě trénovat model nad databází nemocnice. Příručka popisuje pravidla, role a technické mechanismy. Praktické nasazení bude vyžadovat standardy, dohled, certifikaci účastníků a vyřešení odpovědnosti za chyby.
Samotné zabezpečené prostředí také neřeší všechny problémy. Model může být špatně navržený, data mohou být neúplná a anonymizace nemusí odstranit každý typ rizika. U citlivých databází bude důležité také rozhodnout, kdo smí výsledek použít, jak dlouho se smí model trénovat a zda lze výsledný model nasadit mimo původní účel.
Indie plánuje konzultace, které mají rámec ukotvit v právním systému. To znamená, že některé části se ještě mohou změnit. Oznámený dokument tedy zatím popisuje směr a technicko-právní základ, nikoli hotovou službu s jednotnými podmínkami pro všechny sektory.
Význam pro Česko a Evropskou unii
DEPA není produkt dostupný českým domácnostem ani služba určená pro firmy v Česku nebo Evropské unii. Jde o indický národní rámec. Pro evropské firmy je ale zajímavý způsob, jak propojit ochranu dat s vývojem AI bez nutnosti vytvořit jednu obří kopii citlivých databází.
Podobný model může být relevantní pro nemocnice, banky, univerzity nebo veřejnou správu také v Evropě. Praktická použitelnost by závisela na evropských pravidlech, smlouvách mezi institucemi a technickém auditu. Z indického příkladu zatím nelze vyvodit, že stejný systém automaticky splní požadavky českého nebo unijního práva.
Nejzajímavější na DEPA proto není samotný slogan o cestování modelu za daty. Důležitá je snaha spojit výpočetní infrastrukturu, smluvní pravidla, ochranu soukromí a audit do jednoho procesu. Indie příručku zveřejnila, ale rozsah skutečného nasazení se teprve ukáže.
FAQ
Bude možné DEPA používat z Česka?
Ne jako běžnou veřejnou službu. DEPA for AI Training je indický rámec navržený pro tamní instituce, infrastrukturu a právní prostředí. Jeho principy mohou být inspirací pro evropské projekty, ale česká dostupnost ani přímé napojení na české firmy oznámené nebyly.
Znamená DEPA, že se citlivá data vůbec nebudou kopírovat?
Ne nutně. Rámec popisuje více možností. Data mohou být anonymizována a předána platformě, nebo mohou zůstat v zabezpečeném prostředí, kde probíhá trénování a testování modelu. Konkrétní režim závisí na klasifikaci dat a pravidlech jejich vlastníka.
Chrání diferenční soukromí před každým únikem informací?
Ne. Diferenční ochrana soukromí snižuje riziko odhalení jednotlivých záznamů při práci se statistickými vzorci. Nenahrazuje správné řízení přístupů, šifrování, audit ani právní odpovědnost za použití dat.
Zdroj: The Register, Press Information Bureau of India a DEPA for AI Training Handbook.