TokenGate nechá jazykové modely číst méně a odpovídat rychleji
Výzkumníci ze Stanfordu a Berkeley zveřejnili modul TokenGate, který při práci s dlouhými dokumenty vybírá důležité tokeny a zbytek přeskočí. Testy ukázaly až 11,3× rychlejší první odpověď, zatím jen u vybraných modelů.
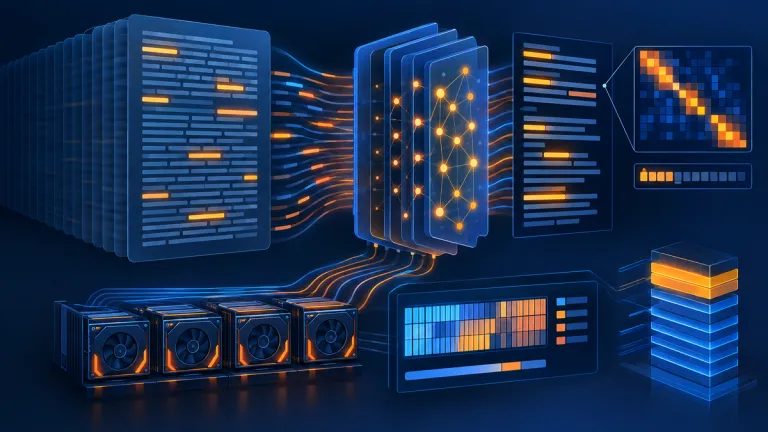
TokenGate zkracuje práci s dlouhým vstupem
Současné jazykové modely obvykle zpracují každý token vstupního textu v každé vrstvě své sítě. Tokenem může být celé slovo, část slova nebo například interpunkční znaménko. U krátkého dotazu to není velký problém. U celého repozitáře, právní smlouvy nebo rozsáhlého technického manuálu už ano.
Nejvíce času model spotřebuje ještě před vytvořením první odpovědi. Této fázi se říká prefill. Model během ní načte vstupní kontext, vypočítá potřebné reprezentace a připraví si interní paměť pro generování. Uživatel tento proces vnímá jako čekání na první token, tedy jako TTFT neboli Time-To-First-Token.
TokenGate do existujícího modelu přidává malý trénovatelný modul. Ten se pokusí odhadnout, které části dokumentu budou pro odpověď důležité. Vybrané tokeny pokračují plným výpočtem, zatímco ostatní se ve vyšších vrstvách přeskočí. Ušetřený výpočet se projeví hlavně u dlouhých vstupů.
Výzkumná práce byla zveřejněna 19. října 2026 na serveru arXiv. Autoři v ní popisují TokenGate jako doplněk pro již natrénované modely, nikoli jako úplně novou architekturu, která by vyžadovala trénování od nuly. ([arxiv.org](https://arxiv.org/abs/2610.26754))
Jak výběr důležitých tokenů funguje
TokenGate rozděluje průchod modelem do tří částí. V nižších vrstvách se zpracují všechny tokeny stejně jako při běžném běhu. Poté malá MLP brána každému tokenu přiřadí skóre důležitosti. Selektor typu top-K ponechá pouze určený počet tokenů a vyšší vrstvy už pracují s tímto zmenšeným výběrem.
Uživatelská otázka zůstává zachována vždy. Prořezává se pouze dokumentová část vstupu. To je praktický detail, protože model může odstranit části podkladového textu, ale nesmí přijít o samotné zadání, podle kterého má odpovídat.
Technický problém spočívá v tom, že operace top-K není jednoduše diferencovatelná. Model by tedy při běžném trénování obtížně zjišťoval, zda vybral správné tokeny. TokenGate tento problém řeší mechanismem nazvaným token-gated attention.
Výzkumníci využili princip podobný routerům z architektury Mixture-of-Experts. Skóre důležitosti se promítne jako dodatečný bias do attention logitů. Díky tomu mohou gradienty během trénování procházet zpět k modulu, který tokeny vybírá. Součástí mechanismu je také naučitelná teplota a zisk pro jednotlivé attention hlavy.
Adaptace používá malý MLP modul a LoRA s hodnotou r=16. Autoři uvádějí, že jeden natrénovaný gate funguje s různými rozpočty ponechaných tokenů. Výcvik proto nemusí vytvářet samostatný model pro každou míru prořezání.
Výsledky testů na dlouhých kontextech
Testy proběhly na modelu Qwen3-1.7B v úlohách RepoBench-P, 2WikiMultihopQA, MultiNews, BioDEX a Needle In A Haystack. Měření porovnávalo běžný prefill s metodami FastKV, SlimInfer, DASH, GemFilter, FlexPrefill a MInference. Výsledky pocházejí z nastavení s jednou grafickou kartou NVIDIA A100 a velikostí dávky 1.
Ve srovnání s plným zpracováním kontextu dosáhl TokenGate zrychlení TTFT v rozmezí 1,4× až 11,3×. Špičková paměť při prefillingu klesla 1,5× až 3,4×. Nejlepší výsledek autoři naměřili v úloze Needle In A Haystack při délce kontextu 16 000 tokenů. První token přišel 11,3× rychleji a špičková paměť klesla 3,42×.
V testu 2WikiMultihopQA dosáhl model 95 procent přesnosti plného kontextu. Prefill byl při tomto nastavení 3× rychlejší a využil 2,7× méně paměti. To je důležitější údaj než samotné maximum 11,3×, protože ukazuje kompromis mezi úsporou výpočtu a přesností na konkrétní úloze.
Autoři také zkoušeli delší vstupy. Gate natrénovaný na 16 000 tokenech dosáhl podle jejich měření zrychlení 12,8× při délce 32 000 tokenů a až 13× při délkách 64 000 a 128 000 tokenů. U těchto měření zůstala úspora paměti přibližně na úrovni 3,43×.
Čísla je potřeba číst opatrně. Nejhorší uváděné zrychlení činilo 1,4× a srovnání různých metod není dokonale přímé, protože některé starší práce používaly jiný model, hardware nebo nastavení. Samotný článek proto správně upozorňuje, že výsledky z různých publikací nelze chápat jako jednotný žebříček.
TokenGate funguje i s hybridní pozorností
Výzkumníci ověřili metodu také na modelu Qwen3.5-2B, který kombinuje klasické attention vrstvy s vrstvami Gated DeltaNet. Tento typ hybridní architektury ukládá část informací jiným způsobem než běžný transformer.
Při úloze Needle In A Haystack s 32 000 tokeny dosáhl TokenGate při umístění brány do třetí vrstvy stejné přesnosti jako plný prefill. Současně byl 3,8× rychlejší než běžné zpracování a 2,1× rychlejší než FastKV. Při umístění brány do první nebo druhé vrstvy se zrychlení zvýšilo na 7,8×, ovšem s poklesem přesnosti do šesti procent.
Rozdíl proti FastKV je v tomto případě praktický. FastKV dokáže podle popisu práce prořezávat pouze klasické attention vrstvy. TokenGate umí pracovat i s vrstvami Gated DeltaNet. To neznamená, že bude automaticky vhodnější pro každý model, ale rozšiřuje počet architektur, na kterých lze podobný přístup použít.
Výhoda proti metodám bez dalšího trénování
Část dřívějších metod token pruning nevyžaduje další trénování. To zjednodušuje nasazení, protože vývojář vezme hotový model a přidá k němu výběr tokenů. Problémem může být přesnost při agresivním prořezání. TokenGate si naproti tomu vyžaduje doučení gate a LoRA adaptéru.
Podle zveřejněných výsledků je tréninkový krok 1,3× pomalejší než u běžného LoRA. Průměrný trénink trval 1,8 hodiny na A100 oproti 2,2 hodiny u porovnávaného nastavení na čtyřech z pěti úloh. Trénování probíhalo na čtyřech kartách NVIDIA A100, zatímco měření inference na jedné kartě.
V porovnání s nejlepšími uvedenými metodami pro prořezávání měl TokenGate dosáhnout až 6,4× rychlejšího prefillingu a až dvojnásobně nižší špičkové paměti. Tyto hodnoty jsou tvrzením autorů práce a vztahují se k jejich experimentálnímu nastavení.
Dostupnost pro vývojáře v Česku
TokenGate není placený chatbot ani cloudové API, které by si mohl běžný uživatel zapnout v prohlížeči. Jde o veřejný výzkumný kód a checkpointy. Zdrojový kód je na GitHubu pod licencí Apache-2.0. Repozitář uvádí požadavek na Python 3.10 nebo novější a CUDA PyTorch 2.9 nebo novější. ([github.com](https://github.com/token-gate-llms/TokenGate))
Pro rychlejší běh je k dispozici volitelné jádro založené na FlashAttention-2. Bez něj projekt používá FlexAttention. Dokumentace počítá s placeholderem {state}, který označuje část vstupu určenou k prořezávání, a s parametrem max_kept_prefill_tokens, jenž určuje maximální počet ponechaných tokenů.
Pro české uživatele je podstatné, že dostupnost v češtině není uvedena jako samostatně testovaná vlastnost. TokenGate upravuje způsob výpočtu nad podporovaným jazykovým modelem, nikoli jeho jazykové schopnosti. Čeština tedy závisí hlavně na konkrétním modelu Qwen a na datech, na kterých byl adaptér natrénován. Ve zveřejněných výsledcích není samostatný benchmark pro české texty.
TokenGate také nemá vlastní cenu ani free tier. Náklady vznikají provozem modelu a případným trénováním adaptéru na vlastním hardwaru. Pro firmy, které zpracovávají dlouhé dokumenty lokálně, může být zajímavá především úspora GPU paměti. Pro běžného uživatele zatím nejde o nástroj, který by byl připravený k instalaci jedním kliknutím.
Co výsledky zatím neříkají
Studie ukazuje výsledky na konkrétních modelech, úlohách a hardwaru. Z těchto čísel nelze vyvodit, že TokenGate stejně zrychlí všechny současné modely nebo každé použití dlouhého kontextu. Výsledky také nesrovnávají TokenGate přímo s cloudovými modely GPT, Gemini nebo Claude. Jde o techniku pro úpravu běhu modelu, nikoli o nový konkurenční chatbot.
Důležitá je také přesnost. Autoři v abstraktu uvádějí, že v testovaných nastaveních nedošlo k její degradaci, konkrétní výsledky ale závisejí na úloze, vrstvě, rozpočtu tokenů a nastavení gate. U hybridního Qwen3.5-2B například vyšší zrychlení přišlo s poklesem přesnosti do šesti procent.
TokenGate je proto zatím hlavně výzkumný modul pro vývojáře, kteří řeší dlouhé vstupy a náklady na prefill. Veřejný kód umožňuje výsledky reprodukovat, ale neodstraňuje potřebu vlastního hardwaru, správného nastavení a ověření na datech konkrétní aplikace.
FAQ
Je TokenGate samostatný jazykový model?
Ne. TokenGate je doplňkový modul, který se přidává k již natrénovanému modelu. V testech byl použit například Qwen3-1.7B a Qwen3.5-2B.
Lze TokenGate používat bez grafické karty NVIDIA?
Zveřejněné měření probíhalo na NVIDIA A100 a repozitář vyžaduje CUDA prostředí. Dokumentace proto cílí na GPU s podporou CUDA. Výkon na jiném hardwaru není v uvedených výsledcích doložen.
Podporuje TokenGate české dokumenty?
Samotný modul není omezený na jeden jazyk, ale zveřejněné testy neobsahují samostatné měření češtiny. Výsledek proto závisí na použitém jazykovém modelu a konkrétním adaptéru.
Zdrojové shrnutí testů na MarkTechPost, výzkumná práce na arXivu a zdrojový kód na GitHubu.